O endpoint de relatório está com p95 acima de dois segundos, o painel de latência está vermelho desde cedo e no canal do time alguém já perguntou se rodaram o profiler. Em Profiling em Python: Encontrando Gargalos com cProfile e memory_profiler eu mostrei o caminho tradicional, e ele tem um detalhe que só incomoda de verdade em produção. Para usar o cProfile, você precisa subir o processo de novo, já com o profiler ligado. Isso significa derrubar o serviço que está exibindo o problema, perder o estado que o reproduz (cache aquecido, pool cheio, o padrão de carga daquela hora) e torcer para a lentidão voltar enquanto você observa.
O Python 3.15 resolve esse problema na biblioteca padrão. A PEP 799 criou o pacote profiling, e dentro dele veio o profiling.sampling, apelidado de Tachyon. É um profiler de amostragem que se conecta a um processo Python que já está rodando, pelo PID, sem alterar uma linha de código e sem reiniciar nada. Eu montei um serviço com um gargalo realista para testar, e o profiler me ensinou mais de uma coisa no caminho, inclusive uma em que o resultado mais “rigoroso” era o errado.
Todos os comandos e saídas abaixo foram rodados no Python 3.15.2.
O serviço
É uma API pequena, só com a biblioteca padrão, que monta um relatório de pedidos de um cliente consolidado por SKU. Os dados ficam num SQLite com 80 mil pedidos (8 mil por cliente, cerca de 2 mil SKUs distintos), e o servidor é um ThreadingHTTPServer, ou seja, cada requisição roda na sua própria thread.
| |
O restante do arquivo é o handler HTTP de sempre, que lê o parâmetro cliente da query string, chama montar_relatorio e devolve o JSON. Quem já fez code review por algum tempo enxerga o problema na linha 24 em dois segundos. A ideia aqui é fingir que não enxergou, porque em produção o código raramente é tão curto e o gargalo raramente está numa função com nome tão sugestivo.
Com quatro clientes concorrentes disparando requisições em loop durante 20 segundos, o serviço entrega 69 respostas, com p50 de 1172 ms e p95 de 2054 ms.
O caminho clássico custa uma reinicialização
Para registro, eu fiz o caminho antigo também. Derrubei o servidor, subi de novo com python -m cProfile -o perfil.prof app.py, rodei a mesma carga e interrompi com Ctrl+C para o arquivo ser gravado. Funcionou. No 3.15, o cProfile enxergou as threads do servidor e apontou a generator expression da linha 24 com 9,8 segundos de tempo próprio. E o overhead, nesse serviço, nem apareceu na latência (p50 de 1173 ms contra 1172 ms sem profiler).
Isso desmonta um argumento que eu mesmo já usei contra o cProfile. O problema dele em produção quase nunca é ser lento demais, e sim que o diagnóstico começa com um restart. Num serviço de verdade, o restart pode ser exatamente o que faz o sintoma sumir por algumas horas.
Vale notar que o cProfile continua existindo. Ele agora é um alias de compatibilidade para profiling.tracing, que é o mesmo profiler determinístico realocado para o pacote novo. Quem saiu de cena foi o módulo profile, a versão em Python puro, que está deprecado no 3.15, com remoção prevista para o 3.17, segundo o What’s New.
Conectando no processo que já está rodando
Com o servidor de pé e a carga rodando, só é preciso saber o PID.
| |
O -d 10 limita a coleta a dez segundos. Sem ele, o profiler fica conectado até o processo terminar, o que num servidor significa até você apertar Ctrl+C. A taxa padrão é de 1 kHz, mil amostras por segundo. A saída foi esta.
| |
Noventa e sete por cento do tempo no select. Nenhuma linha do app.py. A primeira reação é achar que o profiler não funciona, e a explicação está na documentação do módulo. Por padrão, o Tachyon amostra só a thread principal. Num ThreadingHTTPServer, a thread principal passa a vida esperando conexões no select e entregando cada uma para uma thread nova. O trabalho de verdade acontece nas outras.
A thread principal não estava fazendo nada
A opção -a (ou --all-threads) amostra todas as threads do processo.
| |
| |
Agora o app.py aparece. Os números de nsamples passam de 10 mil porque cada fotografia registra a pilha de todas as threads vivas naquele instante, então quatro requisições simultâneas rendem até quatro entradas por amostra.
E o perfil diz uma coisa que pode mandar a investigação para o lugar errado, porque metade do tempo está na linha 16, o fetchall() da query. Lendo isso, eu iria olhar o plano de execução, conferir o índice em cliente_id e talvez abrir um ticket para o time de banco. O índice existe e a query é trivial.
Tempo de relógio acusa o banco
O modo padrão do Tachyon é --mode wall, que mede tempo de relógio. Ele registra em que ponto do código cada thread está, esteja ela trabalhando, dormindo ou esperando alguma coisa. Uma thread parada na linha 16 conta como “tempo na linha 16”, seja qual for o motivo da espera. E existe um motivo que um servidor com threads em CPython (sem a build free-threaded, que eu discuti em A GIL finalmente saiu do caminho: o que muda com o Python 3.14 free-threaded) sempre tem à mão, que é esperar o GIL.
O módulo sqlite3 libera o GIL enquanto o SQLite executa a query. Quando a query termina, a thread precisa pegar o GIL de volta para montar as tuplas do resultado em objetos Python, e se outra thread está ocupada rodando bytecode, ela espera. Para separar uma coisa da outra, o Tachyon tem mais dois modos úteis aqui. O --mode cpu só registra amostras de threads que estão de fato executando num núcleo, e o --mode gil só registra amostras de quem está segurando o GIL.
| |
| |
A generator expression segura o GIL em 93% das amostras. O fetchall(), que levava a culpa de metade do tempo de relógio, aparece com 3%. No modo cpu o quadro fica no meio do caminho (67,6% para a generator expression, 28,9% para a linha 16), o que faz sentido, já que o SQLite gasta CPU de verdade fazendo a leitura, só que sem segurar o GIL.
A leitura correta, então, é que as threads paradas no fetchall() estavam, na maior parte do tempo, na fila do GIL, esperando a thread que varria uma lista de dicionários para cada pedido. A documentação resume o modo gil como uma forma de descobrir qual código está impedindo as outras threads de rodar bytecode Python. Foi exatamente o que aconteceu.
Conferindo o profiler contra o relógio
Um profiler de amostragem é uma estimativa estatística, e eu quis saber se ele estava estimando bem. Fiz uma cópia do serviço que mede cada etapa por fora, com time.perf_counter() em volta das duas chamadas de montar_relatorio, acumulando o tempo de todas as threads.
| |
Em duas rodadas de 15 segundos com a mesma carga, carregar_pedidos somou 41,5 s e 38,4 s, e consolidar_por_sku somou 20,5 s e 23,2 s. A proporção fica em torno de 1,8 para 1. O perfil em tempo de relógio deu 49,8% contra 27,9%, uma proporção de 1,8 para 1. O Tachyon acertou o tempo de relógio. Quem precisava de contexto era eu.
Agora a parte que me surpreendeu. A documentação descreve a opção --blocking, que suspende o processo-alvo durante cada amostra, lê a pilha e retoma a execução. Ela existe porque o modo padrão lê a memória com o processo rodando, e em código com muitos generators ou com a pilha mudando muito rápido isso pode produzir pilhas incompletas ou inconsistentes, inclusive pilhas “that never actually existed”, nas palavras da própria documentação. Parece o modo mais confiável, certo? Rodei com ele.
| |
As proporções se inverteram, com 50,2% para a generator expression e 23,8% para o fetchall(), quase 1 para 2, longe do 1,8 para 1 que o cronômetro mediu. Cada pilha capturada com --blocking é real, isso a documentação garante. O que mudou foi o programa, porque suspender e retomar todas as threads mil vezes por segundo mexe justamente na disputa pelo GIL que eu estava tentando observar. A própria documentação avisa que o processo fica mais lento e recomenda não usar taxas altas nesse modo. Eu não esperava que a distorção fosse tão grande num cenário tão comum.
Depois disso, minha regra é usar o modo padrão primeiro, sempre. O --blocking entra quando o perfil mostra pilhas que não fazem sentido (frames de generators misturados com chamadas que não podem coexistir, por exemplo), e mesmo assim desconfiando das proporções quando o problema envolve concorrência entre threads.
O “Error rate” que aparece no topo
Nas saídas acima, o modo padrão com -a mostrou Error rate: 5.05. Na primeira vez que vi o número, num script de teste com um loop apertado sobre um generator, ele chegou a 15%, e eu fui ler o código-fonte para entender o que ele mede. A conta está em Lib/profiling/sampling/sample.py, e o número é a porcentagem de tentativas de amostra em que a leitura da pilha falhou e a amostra foi descartada. As falhas mais comuns que encontrei foram RuntimeError: Incomplete sample: did not reach base frame, justamente a leitura que pegou a pilha no meio de uma mudança.
No mesmo script de teste, o --blocking derrubou a taxa de 15% para 2,5%, e um processo parado num time.sleep() deu 0%. A documentação trata do assunto sob o nome de eficiência de amostragem e diz que é uma métrica informativa. Com amostras suficientes, o perfil continua estatisticamente válido mesmo com algumas falhas. O relatório HTML do modo --heatmap classifica a taxa como alerta a partir de 5% e como erro a partir de 15%, o que dá uma boa régua do quanto se preocupar.
Corrigindo, e deixando o profiler apontar o próximo passo
A correção da linha 24 é a que todo mundo já sabia desde o começo. Basta indexar por SKU num dicionário em vez de procurar numa lista.
| |
Com a mesma carga de 15 segundos, o serviço passou de 53 para 455 respostas, e o p50 caiu de cerca de 1150 ms para 128 ms. O detalhe que fecha a investigação é que o tempo médio de carregar_pedidos por requisição caiu de uns 755 ms para 125 ms, sem que a query fosse tocada. Era fila do GIL.
Rodando o Tachyon de novo em modo gil, a linha 16 agora lidera com 64,7%. Faz sentido, porque o serviço traz 8 mil linhas do banco, transforma cada uma numa tupla Python e só então soma. Isso é trabalho para o banco.
| |
Mesmo resultado (conferi as três versões umas contra as outras), 1759 respostas em 15 segundos e p50 de 31 ms. De 1,1 segundo para 31 ms, e nenhuma etapa do diagnóstico exigiu reiniciar o serviço.
Flame graph para quem não quer ler tabela
A saída padrão é a tabela no formato do pstats, mas para mostrar a investigação para alguém o flame graph costuma funcionar melhor.
| |
O resultado é um HTML autocontido (o meu deu uns 720 KB) que abre em qualquer navegador. Esta é a captura do perfil do serviço ainda lento, com 20 segundos de coleta sob a mesma carga.
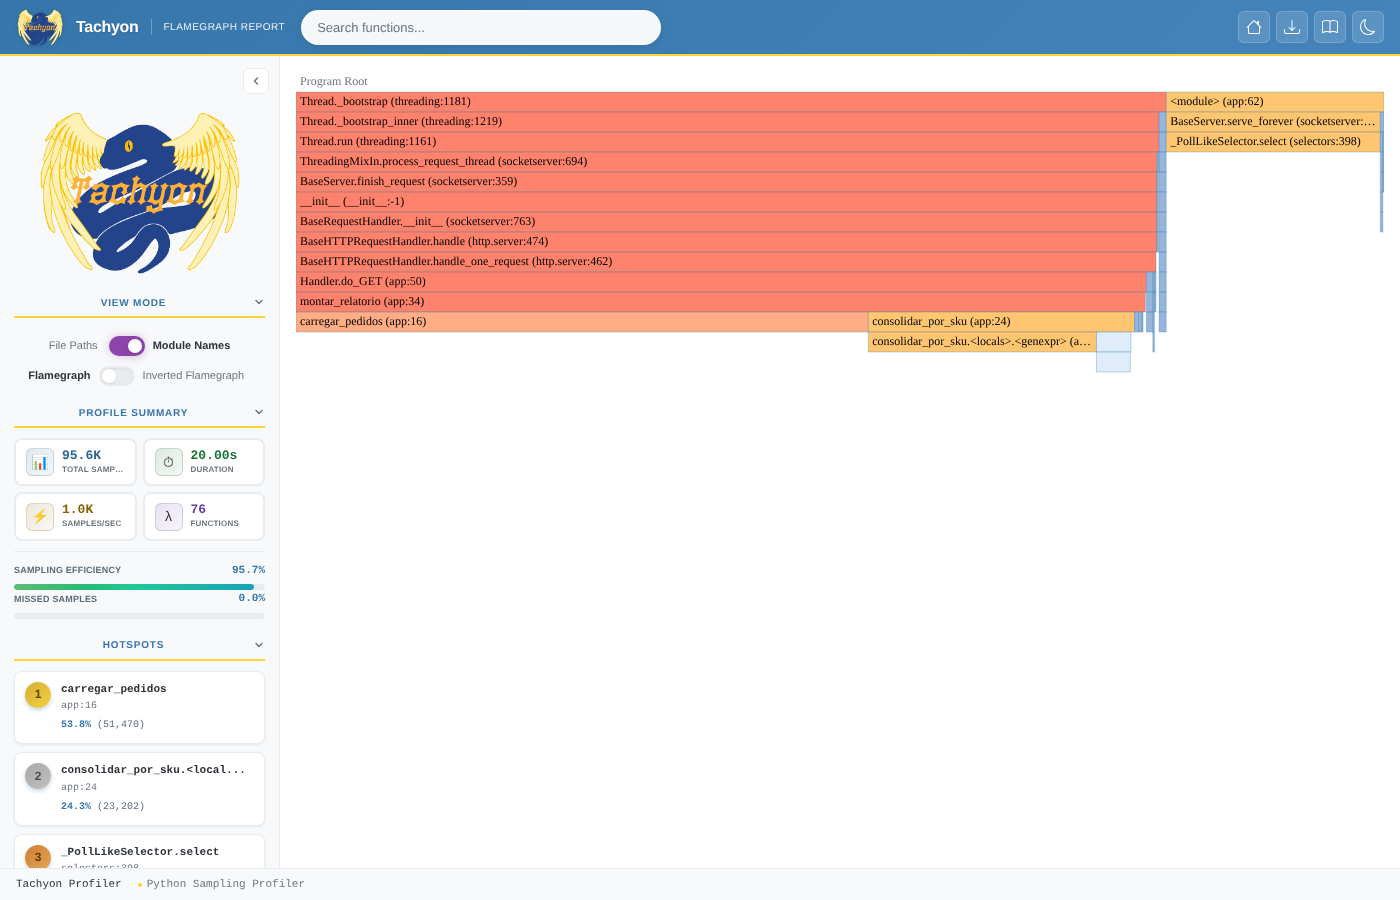
Cada retângulo é uma função, e a largura dele é a fração das amostras em que ela estava na pilha. A leitura vai de cima para baixo, da raiz até a função que estava executando no momento da amostra. O bloco largo à esquerda reúne as threads que atendem requisições, e a coluna estreita à direita é a thread principal parada no select. Na base, carregar_pedidos ocupa mais da metade da largura e consolidar_por_sku aparece logo ao lado com a generator expression. É o mesmo retrato da tabela em tempo de relógio, com o mesmo risco de leitura errada, por isso o modo de coleta continua valendo mais do que o formato de saída. Na barra lateral, o “Sampling efficiency” de 95,7% é o complemento do Error rate que o terminal mostra, e a lista de hotspots repete o topo da tabela.
Há também --heatmap, com contagem de amostras linha a linha no código-fonte, --gecko para o Firefox Profiler, --collapsed para as ferramentas de flame graph do Brendan Gregg, e o --live, uma interface no terminal no estilo do top. Para processo travado, o subcomando dump imprime uma fotografia única da pilha de cada thread, no formato de traceback, e sai.
O que precisa estar no lugar
Ler a memória de outro processo exige permissão do sistema operacional. No Linux, a documentação lista três caminhos, que são rodar como root, ter a capability CAP_SYS_PTRACE ou ajustar o Yama em /proc/sys/kernel/yama/ptrace_scope. Com o valor 1, o ptrace fica restrito a processos pais, e o profiler não é pai do seu servidor. A documentação sugere echo 0 | sudo tee /proc/sys/kernel/yama/ptrace_scope, mas isso afrouxa a proteção do sistema inteiro até o próximo boot. Para uma sessão pontual de diagnóstico, eu prefiro o sudo direto no comando. Se o Python veio do uv, o executável fica em ~/.local/bin, que não está no PATH do root.
| |
O subcomando run (python3.15 -m profiling.sampling run app.py) dispensa essa permissão no Linux, porque o profiler passa a ser o pai do processo. Só que aí você volta a reiniciar o serviço, que é o que eu queria evitar.
A segunda exigência é a versão. Profiler e processo-alvo precisam estar na mesma versão menor do Python, e não dá para misturar a build free-threaded com a padrão. Se a produção roda 3.14, o Tachyon do 3.15 não se conecta nela.
A terceira me pegou no primeiro teste. Eu subi o serviço com uv run app.py, peguei o PID com pgrep e o profiler respondeu com este erro.
| |
O PID 3795 era o do uv, que fica vivo como processo pai do Python.
| |
O alvo certo é o 3801. Em qualquer wrapper (gerenciador de processos, script de entrada do container), confira se o PID é mesmo de um interpretador Python.
E, falando em uv, tem uma última armadilha. A lista de versões do Python que ele sabe instalar vem embutida no próprio binário. Com um uv antigo, uv python install 3.15 instala um beta do 3.15 sem reclamar. Rode uv self update antes e confira com uv python list 3.15 se a versão não tem um b no nome.
E quem ainda está no 3.12
A maior parte dos serviços em produção ainda não está no 3.15, e não vai estar tão cedo. Para eles, as ferramentas que inspiraram o Tachyon continuam valendo, e o What’s New agradece nominalmente ao py-spy, ao Austin, ao Pyflame e ao rbspy. O py-spy, em particular, faz o mesmo tipo de attach por PID e suporta uma faixa ampla de versões do CPython com um binário só, o que o Tachyon, por exigir a mesma versão menor, não faz.
O que o 3.15 muda é que essa ferramenta passa a estar em qualquer instalação do Python, sem uv add, sem binário separado e sem negociação com o time de segurança para instalar mais uma coisa no servidor. E as lições desse serviço valem para qualquer profiler de amostragem. Amostre todas as threads, desconfie do tempo de relógio quando há disputa pelo GIL, e confira o profiler contra uma medição independente quando o resultado for decidir o que você vai atacar no próximo dia de trabalho. A documentação ainda lembra uma coisa óbvia que a gente esquece. Para scripts que terminam em menos de um segundo ou quando você precisa da contagem exata de chamadas, o profiling.tracing continua sendo a ferramenta certa.
Confesso que passei mais tempo do que gostaria olhando para aquele Error rate, e no fim ele era o menor dos problemas, porque quem estava me enganando era o perfil “rigoroso” com --blocking. Se você já conectou o Tachyon em algum serviço de verdade, ou tem uma história de perfil que acusou o culpado errado, me chama em @riverfount@bolha.us. Quero saber o que o seu --mode gil encontrou.